
Meenutan Sirbi lugejale, et ma pole hariduselt lingvist. Tehisintellektile ei lähene ma serveripidamise või klienditoe seisukohast, vaid osutan, kuidas või miks ei sobi statistikapõhine töötlus meie kalli eesti keelega kohe sugugi kokku.
Pärismaalastel on eeliseid
Arizona hopi indiaanlaste keel on eriline. Kui eesti keeles ütleme germaanimõjuliselt lööb välku, siis eeldame tegijat, olgu tol parasjagu nimeks Tor, Pikne või Perun. Hopi keeles on see rehpi: ei ole eraldi tegijat ja sähvatust, asja ega tegevust – on vaid kestev sündmus.
Miks alustan just sellest? Väidetavalt sobib hopi keel ideaalselt kvantmehaanika selgitamiseks, sest väljendab ühekorraga mateeria ja laine kaksust. Indoeuroopa keeled jooksevad sealpaigas mõnusasti kokku, kuivõrd tegijat ja tegevust käsitletakse eraldi. Hopi keeles pole vaja osutada, et seal on elektron. Öeldakse: elektronitsemine.
Kvantfüüsik David Bohm pakkus hopidelt malli võttes välja rheomode’i-nimelise keele, mis indoeurooplaste mure lahendab. Eesti keelest polnud ta ilmselt kuulnudki. Ent eesti keeleski saab võtta ingliskeelse abstraktsiooni security ja keerata selle iroonilises võtmes elusaks, kuid eesmärgistamata protsessiks – turblemiseks, tegijaks on siis turbleja. Või kuidas oleks pilvluse ja pilvlejaga vastuseisuna eurokäsulaua (pilvemääruse) jõledale juurutajale (deployer) neis paragrahvides, kus mõeldud ju hoopis pilve kasutuselevõtjat?
Asümmeetria ongi keeltele omane. Kui tõlkida inglisse tantsisklemine, siis on tulemuseks pikk ja lohisev dancing in a light, playful manner. Ka plekkaju saab aru, et keeled pole ei ühe-, sama- ega võrdväärsed. Tõlkevea tõttu loeb eestlane pilvemäärust tühja ega mõikagi, et tal lasuvad seoses pilves plekkajus ringisopramisega üldse mingid juriidilised kohustused. Sest miskit on tõlkes kaduma läinud …
Viimasel ajal Eestimaal
Plekkajuga on meil segased lood. Kliimaministeerium kurdab: pööbel klopsib plekkaju toel kokku sedavõrd mahukaid pöördumisi, et töötajad ei jaksa enam vastata. Ka kohus on AI-tugistele sarikaeblejatele esimese laksu ära andnud. Naaberministeerium levitab aga AI-koera klähvatusi, et Tartu rahu pühitsemine võib solvata elanikkonna mõningase osa tundeid. Ai-ai? Ei! Ei!
Ministeeriumide arvates on vaja plekkaju ilmtingimata viia igale töökohale, märkamata, kuidas tolle eesti keel logiseb. Kooskõlas Zipfi säädusega on kümme sagedasimat inglise keeles ette tulevat tõukenit1: the, <koma>, <punkt>, of, and, to, a, in, is, that. Eesti keele puhul on esikümme selline: olema (ja selle vormid), ja, tema, see, ei, et, kui, mina, mis, aga.
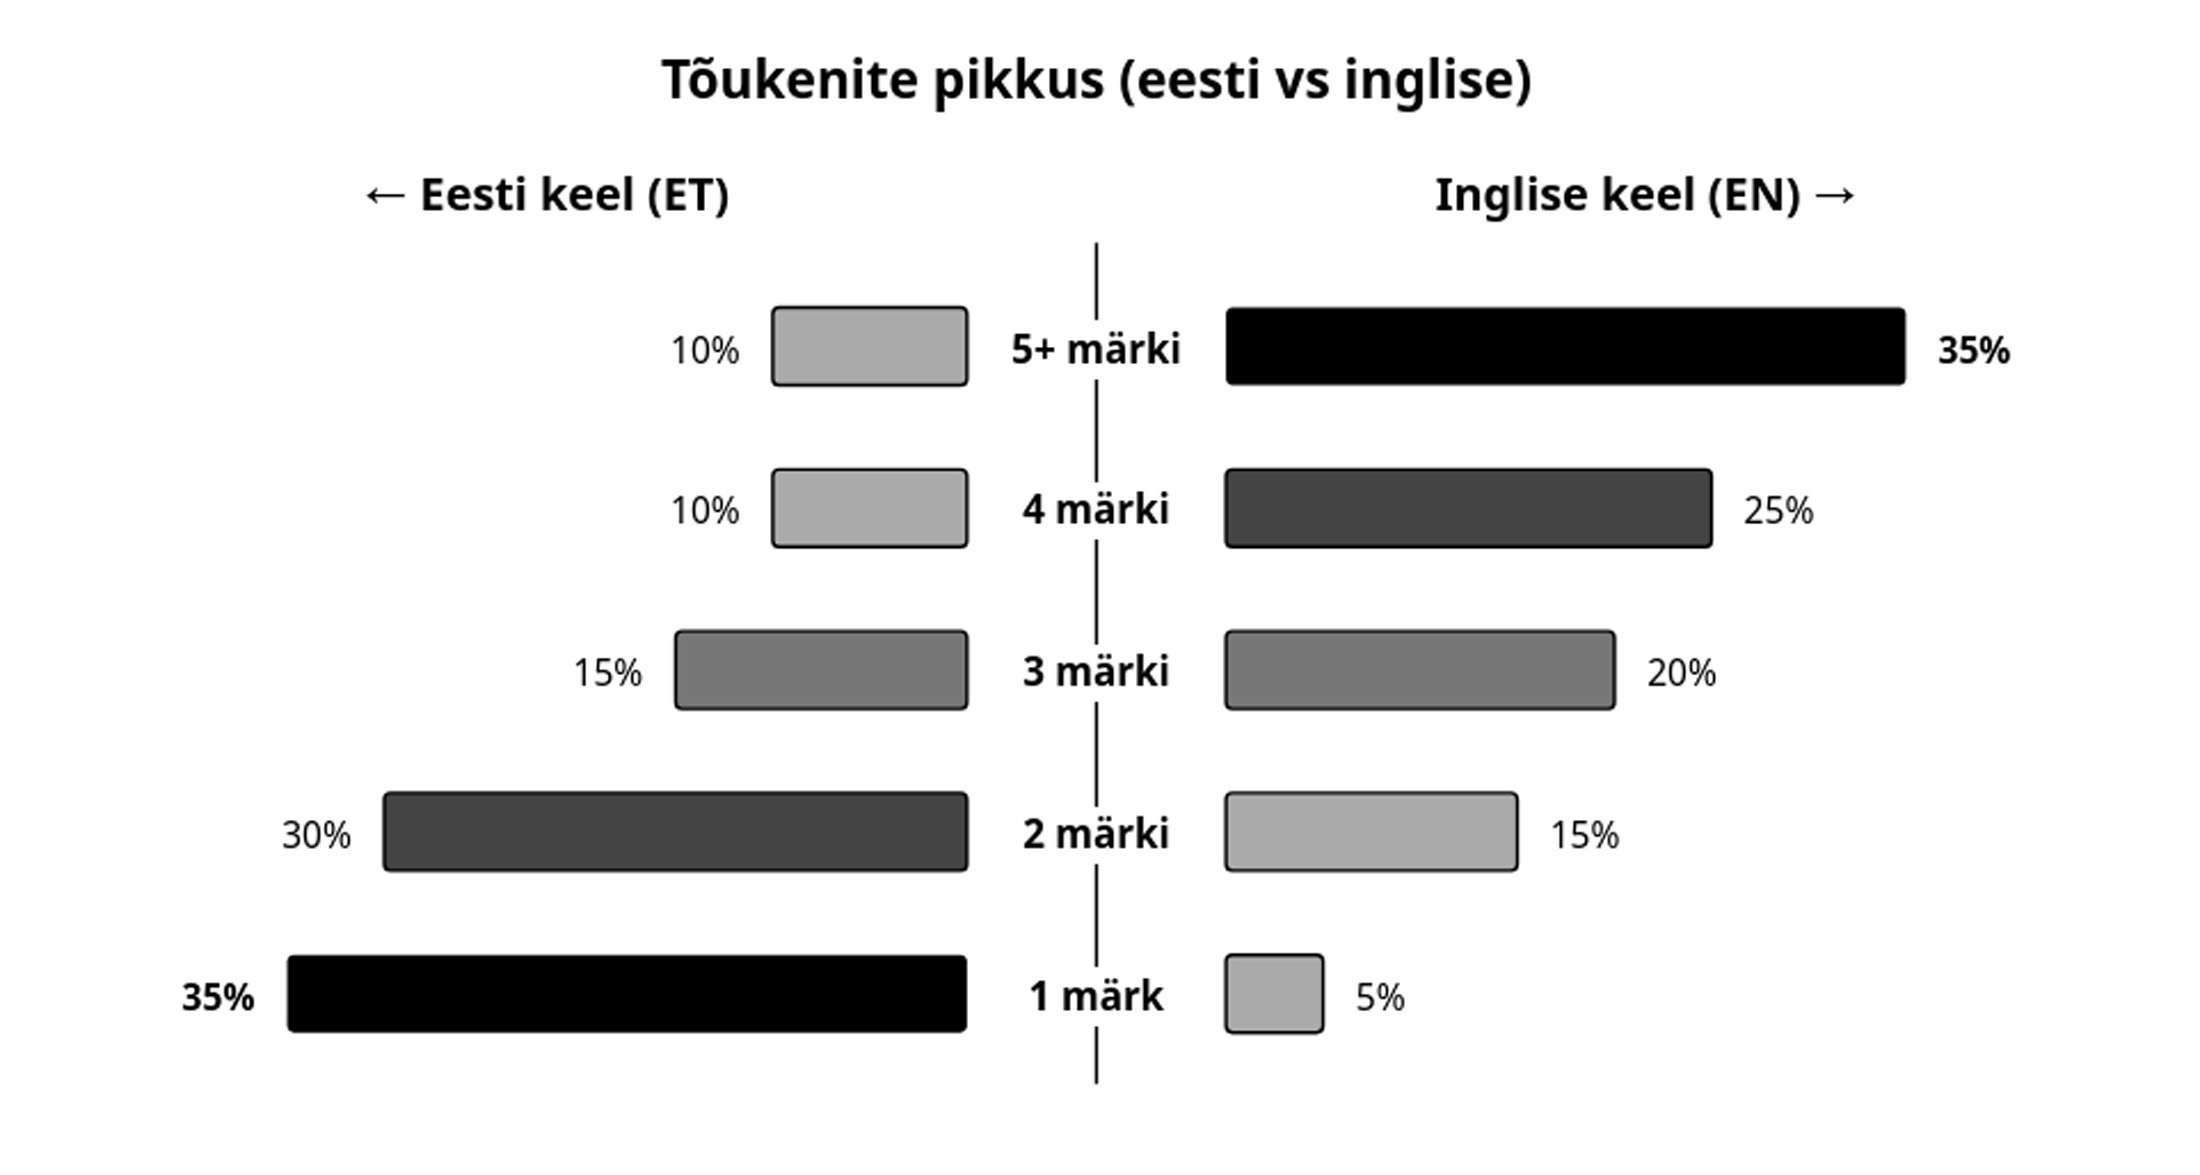
Mure algab sellega, et AI va koer (õigemini BPE ehk andmete tükeldamise algoritm temas) jupitab eesti keelt inglise reeglite kohaselt: _Kui / _Ar / no / _is / aga / _ko / oli / maj / ja / _jõ / ud / is / , / _ol / id / _tun / nid / _juba / _al / an / ud / . Kasutaja lausutud üheksast sõnast sai siin 22 tõukenit. Ebatõhusustegur on 2,4. Täpitäheline kõnepruuk toob kaasa hullemadki äärmused. GPT-4 tõukendaja cl100k_base lammutab liitsõna uusaastaöövastuvõtt lahti sedasi: u / us / a / ast / a / ö / ö / v / ast / u / v / õ / tt . Kokku 13 tõukenit. Iga täpitäht võtab rauakolaka mälus sama palju ruumi kui mõni sage ingliskeelne sõna (nt environment). Juuresolevalt jooniselt paistab, mis täpselt mälumahtu sööb.
Praktikas kujuneb eesti keele ebatõhususteguriks (TWR – Token-to-Word ratio) umbes 2-3. Kui meie põllumeestele antakse soojamaa riigiga võrreldes paarkümmend protsenti vähem eurotoetust, siis on sead koos peremeestega kohe Toompea lossi ees ruiglemas. Kui aga plekkaju tõhusus eesti keele puhul ongi a priori kaks-kolm korda väiksem, siis seda isegi mitte ei märgata. Peaasi et Lunapargi nõbust plekkaju oleks lõbustusvahendi ja olmepsühholoogina igal töökohal esindatud, muu pole oluline. Kavalamad jorsid tönkavad plekkajuga inglist, sest siis kulub tõukenisi2 kolm korda aeglasemalt. Ja keegi polegi märganud (ka mitte Eesti.ai), et plekkajumajanduses tähendab see kolm korda väiksemat tööviljakust. Selliselt stardipositsioonilt me galaktika viie rikkama hulka vaevalt välja rabeleme.
Inglise keele korral TWR=1. Lääne-Euroopa keelte puhul 1,3–1,5. Soome-ugri ja slaavi keelte puhul 2–3 ning mitteladina tähestike (hindi, tamili, gruusia) puhul TWR=4–8+.
Lisaks TWRile leidub igasugu muid indeksisi, nt informatsiooni sünteetilisuse indeks S: et mitu morfeemi sisaldub ühes sõnas. Inglise keele puhul 1,1, eesti keele puhul 2,5–3,5 ja grööni keele puhul 5–10 või isegi enam. Kogu lause võibki eskimotel koosneda vaid ühestainsast sõnast: tusaanngitsuusaarpilualuujunga.3
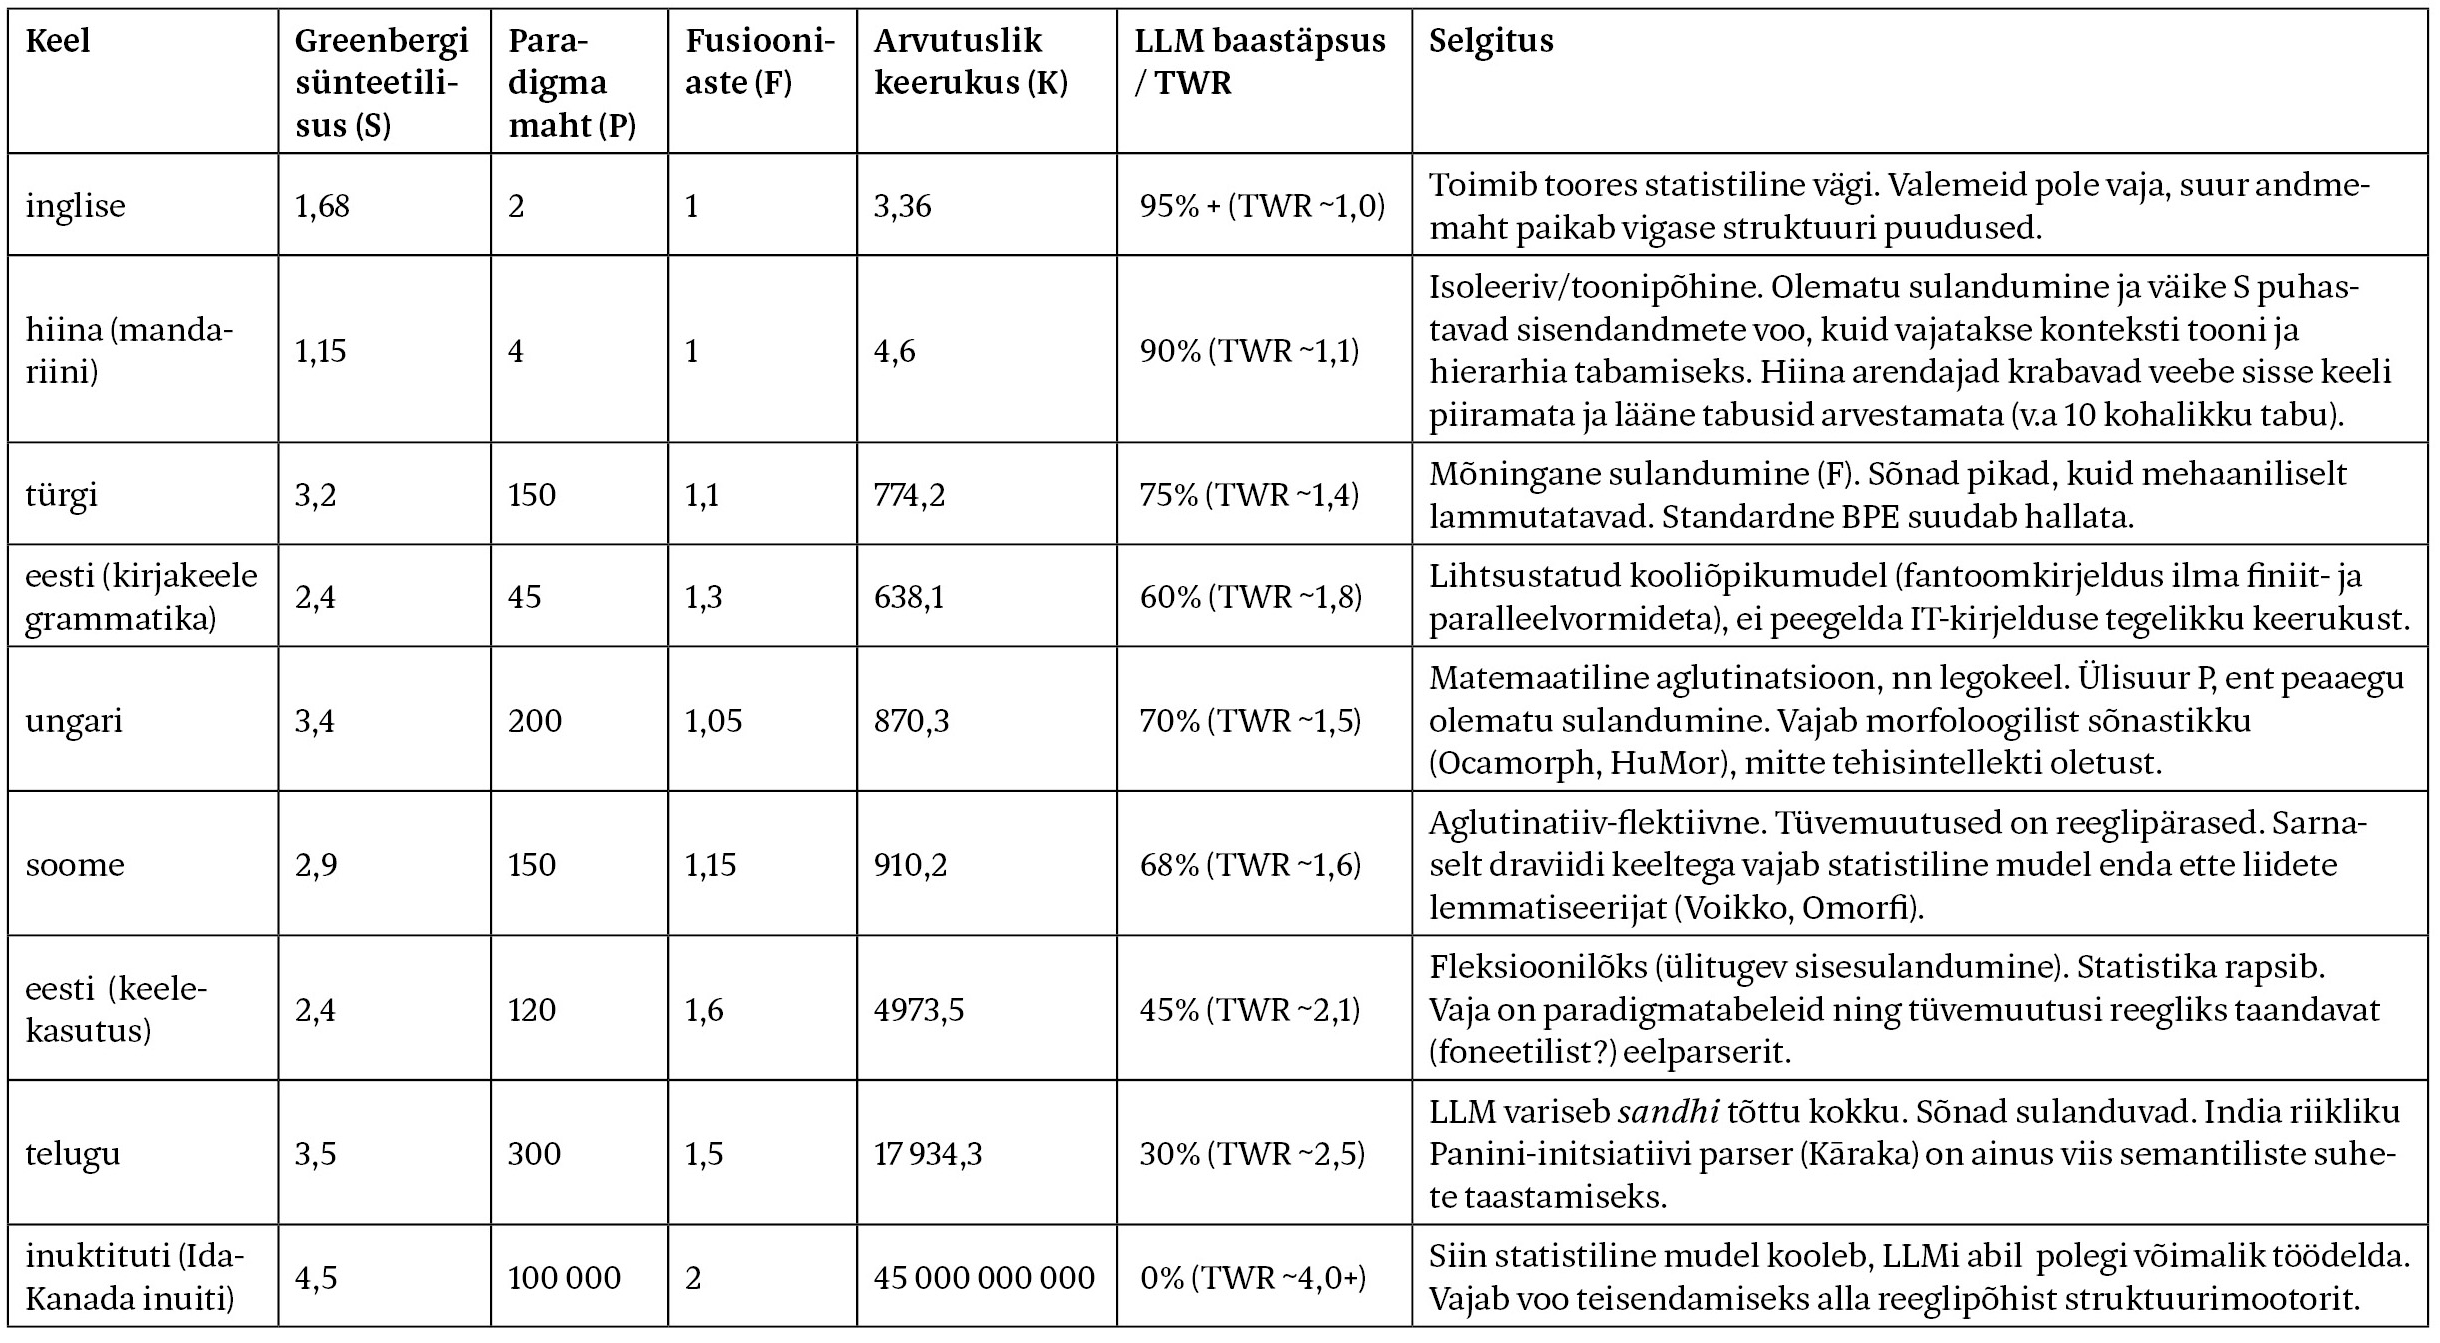
Järgmine põnev parameeter on sulandusaste F (fusion index). On kerglased (analüütilised) keeled, kus sõnu pikitakse nagu maasikmarju kõrre otsa: mandariini ja inglise keel. On keskkeerukad aglutinatiivsed keeled (türgi, ungari, suahiili). Ja sealt algab statistikamasina õudusunenägu: flekteerivad-aglutineerivad keeled (eesti, soome, telugu), kus sõnapiirid sulavad kokku, on astmevaheldus, laadivaheldus, vokaalharmoonia. Statistika enam ei tööta, iga sõna kohta tuleb tekitada eraldi graaf, klotside lineaarne rittaladumine annab tulemuseks jaburduse. Superpaheks on mikrosulandumine: tege + b → teeb. Olen siinkohal üritanud (vt tabel) keeli järjestada selle põhjal, kui hästi või halvasti need LLM-tehnoloogiale alluvad.
Asi läheb aga veelgi hullemaks. Mudeli tähelepanumaatriksi (attention matrix) mõõt kasvab ruudus. Kui tõukenisi on kolm korda rohkem, siis on tähelepanumaatriksi maht suurem juba 9 korda. Seega on vaja vastuse genereerimiseks hullult rohkem mälumahtu ja teenindusenergiat. Mudel ise elab Meerikas emme juures, seega kasvab ruutsõltuvuslikult ka võrguliikluse maht. Nii et parem räägi lühilausetega, on rohelisem!
Algoritmiteaduses tuntakse säärast mõistet nagu arvutuslik keerukus (n-ö Big O notation). Inglise keele korral on lauses suhete tuvastamise keerukus O(N). Eesti keele puhul aga, eriti liitsõnades ja vaba sõnajärjega lausetes, hüppab keerukus O(N³) või halvimal juhul isegi O(2N) peale. See juhtub, kui mudel üritab semantilisi ahelaid eristada puhtstatistiliselt. Süsi muudkui põleb katlas ja suitsu muudkui tuleb, niipea kui eesti keeles suu avad …
Grande finale
Kui mõnele pole veel selge, kuhu ma tüürin, siis tahan konstateerida, et on äärmiselt ebailus üritada eesti keelt lammutada statistilise aparaadiga. Küsisin plekkajult, kuidas ta mu kimbatust ametnikule selgitaks. Plekkaju vastas: „Kui ametnik ütleb: „Aga paneme eesti keelele lihtsalt rohkem GPUsid ja tekstikorpusi peale!“, siis sina näitad Excelist veergu „Arvutuslik keerukus (K)“: „Vaadake, härra/proua ametnik. Inglise keel on nagu mänguklotside rida (K=3,36), eesti keel aga nagu Minotaurose labürint.“ Kui ehitada eestikeelset torni, siis ei ole fusiooni ehk sulandumise tõttu tegu mitte lineaarse liitmise, vaid astendamisega. Eesti keele keerukustegur on statistikaarvuti jaoks sadu kordi suurem kui inglise keelel.
Skaala teises otsas, telugu või eksimo keele puhul, tõuseb keerukus sulandumise tõttu üldse lakke. Puhtalt statistiline arvuti ei suudagi seda eales ära õppida, sest universumis pole nii palju treenimisandmeid. Ja vaadakem nüüd uuesti tabelit: millega eesti keel enim sarnaneb? Seetõttu ongi vaja matemaatilist valemit (reeglipõhist parserit), mis selle eksponentsiaalse keerukuse enne arvutile ette söötmist ribadeks võtab ja lineaarseks muudab.
Eesti keele tragöödia seisneb asjaolus, et statistika mõttes paikneb see täpselt töödeldavate ja töödeldamatute keelte vahepeal. Lihtsamaks otstarbeks nagu kodanikult raha äravõtmine kõlbab statistiline töötlus suurepäraselt. Keerulisemateks pruukideks, nagu teadustööd, patendikirjeldused ja tuumajaama ohutusjuhendid, ei sobi säherdune puuinglisel põhinev peaaegu-eesti keel teps mitte – pauk on kindel, küsimus vaid, millal tuleb.
Statistikale on vaja alla panna grammatikavalemid! Statistika eesti keele puhul ei päde.
1 Tõuken (ingl token). Kasutan jäärapäiselt terminit tõuken, kuigi ÕS 2025 pakub sobivana tookenit ja tokenit.
2 Autori soovil tõukenisi, indeksisi (osutamaks mitmuse osastava paralleelvormidele). – Toim.
3 Plekkaju umbes-täpselt tõlge: „Mina teen täielikult ja tüütult näo, nagu ma ei kuuleks.“
